
Flux produit et shopping IA : votre fichier de 2021 ne passera pas 2027
Je reprends un sujet qui me passionne et qui, mis à part quelques acteurs spécialisés, ne semble pas être dans le plan d’action des e-Marchands : le flux et son impact actuel et futur sur les LLM.
Quand ChatGPT affiche huit produits dans un carrousel, il n’a pas lu votre fiche produit.
Il a recopié Google Shopping, qui n’a lu qu’une chose : votre flux produit. Sauf que ce flux, la plupart des marchands ne l’ont pas rouvert depuis le paramétrage de leurs campagnes Shopping.
Entre les huit nouveaux champs pensés pour l’IA et la limite d’image qui passe à 500 × 500 le 31 janvier 2027, ce fichier vient de redevenir un chantier permanent.
ChatGPT ne découvre pas vos produits, il recopie Google Shopping
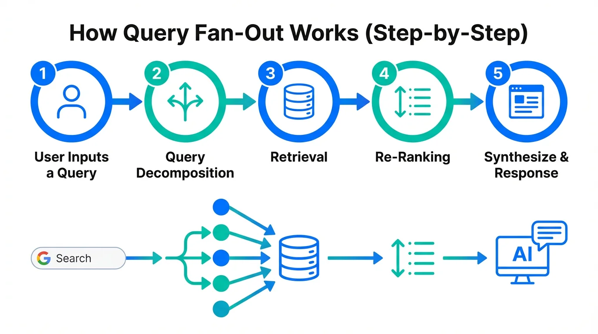
En mars 2026, Tom Wells et Malte Landwehr (Peec AI) ont décodé un champ planqué dans le code source de ChatGPT et reconstruit les URL qu’il contenait. Sur plus de 43 000 produits analysés, 83 % correspondaient au top 40 organique de Google Shopping. Bing plafonnait à 11 %, et ces produits-là se retrouvaient presque tous chez Google aussi. Mieux : 60 % des correspondances fortes venaient du top 10, et l’ordre du carrousel reprenait l’ordre de classement Shopping. L’étude est publiée sur Search Engine Land, et l’interview de Landwehr chez Seeders explique pourquoi ce résultat contredit frontalement le discours ambiant sur les intégrations propriétaires.
Le mécanisme s’appelle le shopping query fan-out : un pipeline de récupération distinct du search fan-out qui rédige le texte de la réponse. Deux tuyaux, deux logiques. Le texte parle de votre marque à partir du web ouvert ; le carrousel, lui, tape dans l’index marchand de Google.
Traduction pour les gens qui vendent des choses : la « GEO e-commerce » de 2026, c’est du Google Shopping organique. Le marché découvre une discipline neuve que les feed managers pratiquent depuis dix ans. Vexant pour les slides, pratique pour les équipes : vous avez déjà le levier, il est juste couvert de poussière.
Le flux ne vous rend pas seulement éligible, il vous classe
Profound a analysé plus d’un million d’offres shopping ChatGPT en juin. Parmi les citations produits tirées directement des flux marchands, environ 99,9 % apparaissaient en première offre. La part des récupérations issues des flux est passée de 4,3 % à près de 20 % du total en six semaines.
La raison n’est pas mystérieuse : la complétude du flux. Une offre issue du flux arrive avec la marque, l’image et les informations marchand renseignées à 100 %. Une offre grattée sur une page arrive avec 0 % de complétion. On imagine que, dans ce cas, l’hallucination n’est pas permise.
Un moteur qui doit reconstituer votre prix depuis un bloc HTML coincé entre deux bannières de réassurance ne sait pas comment l’interpréter. Par contre, le flux, lui, parle sa langue avec sa structure.
Les huit champs que Google a explicitement branchés sur l’IA
⚠️ Position officielle de Google. Depuis janvier 2026, Google enrichit la spécification produit Merchant Center de champs destinés au commerce conversationnel — AI Mode, Gemini, Business Agent — officialisés comme « attributs conversationnels » lors de Google Marketing Live en mai.
Huit d’entre eux portent dans la doc la mention explicite « principalement destiné aux expériences conversationnelles comme AI Mode ». Ils sont optionnels, n’affectent pas l’approbation des produits, et Google ne documente aucun effet direct sur le classement. Emmanuel Flossie (FeedArmy) en a fait un inventaire détaillé, repris par PPC Land.
Le détail des huit, parce que c’est là que tout se joue :
• `product_highlight` — des fragments de phrase sur les bénéfices, pas les specs. Entre 1 et 150 caractères chacun, 4 à 6 recommandés, jusqu’à 100.• `product_detail` — les specs techniques, elles, avec trois sous-attributs : nom de section, nom d’attribut, valeur. Regrouper par sections nommées (Connectique, Mémoire, Autonomie) donne un schéma exploitable, là où une liste plate de paires clé/valeur ne donne presque rien.
• `variant_option` — le nouveau venu, et celui qui débloque le plus de cas. Jusqu’ici, hors des six dimensions standard (couleur, taille, matière, motif, âge, genre), une variante n’avait aucun champ. Un portable décliné par carte graphique ? L’IA devait le déduire du titre. Désormais c’est nom + valeur, répétable 30 fois.
• `item_group_title` — le titre générique commun à toutes les variantes d’un groupe, distinct du titre de chaque variante et sans mention de taille ni de couleur. 150 caractères, mais seuls les 70 premiers s’affichent en général.
• `related_product` — six types de relation : part_of_set, required_part, often_bought_with, substitute, different_brand, accessory. C’est ce qui permet à un agent de répondre à « qu’est-ce qu’il me faut d’autre » ou « vous avez une alternative ». Trois sous-attributs par entrée, une ligne par relation — pas de liste séparée par virgules.
• `question_and_answer` — vos FAQ, directement dans le flux. Jusqu’à 30 paires, 1 000 caractères par champ, 10 000 au total par produit.
• `document_link` — jusqu’à cinq PDF publics par produit : notice, guide de montage, fiche technique, guide des tailles. Google en extrait le contenu pour répondre en conversation. HTTPS, 50 Mo max, crawlable, URL stable.
• `popularity_rank` — un score de 0 à 100 reflétant les ventes réelles du produit par rapport au reste de votre catalogue.
Maintenant, sur le point de pratique, quelques points.
D’abord, « optionnel » chez Google signifie généralement « vous le regretterez tranquillement dans six mois ». Ce n’est pas une raison pour lancer un chantier d’enrichissement sur 40 000 SKU parce qu’une slide de conférence vous a fait peur. On commence par les top références qui font le chiffre, on regarde, on décide ensuite.
Ensuite, document_link est de loin le plus sous-estimé de la liste, et le plus rentable pour un catalogue technique. Vos notices existent déjà, elles sont en PDF sur un serveur, et personne ne les lit. Les déclarer, c’est laisser Google répondre à « comment ça se monte ? » avec votre propre documentation plutôt qu’avec un forum. Pour du B2B, de l’équipement, de la pièce détachée, c’est le meilleur rapport effort/signal de toute la spec.
Enfin, méfiance sur le format. Le piège n’est pas conceptuel, il est bêtement syntaxique : une virgule dans un product_highlight en CSV et votre valeur se coupe en deux au parsing. Travaillez en TSV, ou échappez proprement. Un attribut mal encodé ne déclenche aucune erreur — il produit juste une donnée fausse que la machine lira avec confiance.
500 × 500 : la deadline que personne ne regarde
⚠️ Position officielle de Google. Le minimum d’image passe à 500 × 500 pixels pour tous les produits, application le 31 janvier 2027, sur image_link comme sur additional_image_link.
Les seuils actuels — 100 × 100 hors textile, 250 × 250 pour l’habillement — disparaissent. Merchant Center affiche des avertissements depuis 2026 dans l’onglet « À corriger », et Google continue de recommander 1 500 × 1 500.
La doc est explicite, et Search Engine Roundtable a relayé l’e-mail envoyé aux comptes.
Dans un premier temps, 500 × 500 est un plancher ridicule en 2026 et personne ne devrait le viser. Google recommande 1 500 × 1 500 et ce n’est pas pour vous embêter— au delà de l’amélioration des écrans dans le temps, cela devrait permettre également une lecture de l’image par les LLM.
L’avertissement ne bloque rien aujourd’hui, ce qui en fait exactement le genre de ligne orange qu’on laisse pourrir dans les diagnostics pendant six mois. Le 31 janvier 2027, elle devient un refus, et un produit refusé n’est pas moins bien classé : il n’existe pas, ni en Shopping, ni en annonces gratuites.
On voit apparaitre des solutions d’upscaling d’images pour les flux, mais encore faut-il pouvoir les tester et s’adapter. Le temps commence à presser.
Un flux n’est pas un fichier de setup, c’est un livrable vivant
C’est le point de bascule, et il vaut plus que n’importe quelle liste d’attributs.
Pendant quinze ans, le flux a été traité comme des fondations : on le branche, on corrige les refus, on se base dessus pour toute la partie Shopping. Ce régime est fini, et pas pour une raison philosophique — pour trois raisons mécaniques.
La fraîcheur, d’abord. Les surfaces IA se rafraîchissent en continu ; le Shopping Graph de Google dépasse les 60 milliards d’offres avec plus de 2 milliards mises à jour chaque heure. Une mise à jour correcte des stocks est donc primordiale.
Les champs eux-mêmes, ensuite, comme popularity_rank est par construction une donnée qui bouge : un score figé au paramétrage ment à Google sur vos ventes au bout d’un trimestre. Google recommande de le mettre à jour via une source supplémentaire quand la popularité évolue sensiblement. Même logique pour les Q/R, qui doivent absorber les questions réelles du SAV, et pour related_product, qui casse dès qu’une référence liée sort du catalogue.
La spec, enfin, qui n’arrête plus de bouger : attributs conversationnels en janvier puis en mai, product_category et durée de promotion en juillet, images en janvier 2027. Le rythme des évolutions dépasse désormais celui des revues de compte trimestrielles. Un flux audité une fois par an est un flux en retard de trois changements de spécification.
Le flux sélectionne, la fiche produit convainc
Attention au raccourci qui se propage déjà en post LinkedIn : « le flux remplace la fiche produit ». Non, ils travaillent en tandem.
Les mêmes données Profound montrent qu’environ 88 % des offres produits de ChatGPT proviennent encore de pages web, et jusqu’à 76 % même chez les marchands dont le flux est connecté. Le flux détermine si vous êtes dans la sélection et à quel rang. La page détermine si l’acheteur sort sa carte, et elle nourrit ce que le modèle raconte de votre marque quand il rédige son paragraphe.
Deux surfaces, deux métiers. Optimisez l’une avec le manuel de l’autre et vous sous-performerez sur les deux.
Et être cité ne suffit pas. Lily Ray a étudié les marques qui se placent n° 1 dans leurs propres comparatifs : environ 69 % étaient citées comme source, mais pas recommandées.
Le piège européen : vous pouvez agir, vous ne pouvez pas mesurer
Voilà l’angle mort que les articles américains ne traitent pas, et qui concerne directement un annonceur français.
Les attributs conversationnels se déploient mondialement : vous pouvez les remplir dès aujourd’hui. Le rapport AI Performance Insights, celui qui compare votre part de voix sur les surfaces IA et signale les attributs manquants, se déploie d’abord aux États-Unis, au Canada, en Australie, en Inde et en Nouvelle-Zélande. Pas en France.
Quant à l’Universal Commerce Protocol et à l’Universal Cart, qui permettent de finaliser l’achat dans AI Mode ou Gemini, le déploiement est prioritairement américain — Lengow en fait un état des lieux détaillé côté francophone.
Le chantier est faisable et recommandé, retour sur investissement invérifiable dans l’interface, une véritable révolution dans le milieu du numérique où tout est présumé mesurable. Pour une agence, c’est la configuration la plus inconfortable qui soit — demander un budget d’enrichissement sans courbe à montrer au comité de pilotage suivant.
Ce qu’on fait en attendant : mesurer la source plutôt que la surface. Impressions et clics des annonces gratuites dans Merchant Center, trafic référent des domaines IA dans GA4, et surtout performance Shopping organique — puisque c’est elle qui alimente le carrousel ChatGPT. On ne mesure pas l’IA, on mesure ce que l’IA lit. C’est imparfait ; c’est disponible aujourd’hui.
Le découplage est d’ailleurs déjà visible ailleurs : selon une étude SE Ranking de juillet, seuls 2,32 % environ des annonceurs apparaissant dans AI Mode ressortaient aussi en organique sur la même requête.
Ce qui vous rend invisible sans jamais déclencher d’alerte
Les refus, vous les voyez : GTIN manquants, image non conforme, prix qui ne correspond pas au site. Le vrai problème, ce sont les trous qui ne lèvent aucune erreur.
• Titres génériques ou templatisés, qui oublient la matière, la compatibilité, la dimension, l’usage — exactement ce sur quoi porte la question de l’acheteur.
• Descriptions boilerplate qui paraphrasent le titre : rien à extraire, donc rien à comparer.
• Variantes non renseignées : « en noir, taille M » ne remonte rien du tout, et c’est précisément ce que variant_option vient corriger.
• Prix non lisible. Previsible a analysé 6,77 millions de sessions référées par l’IA : un « prix sur demande » ne donne strictement rien à comparer à la machine. Les comptes B2B et lead gen qui ont fait de l’opacité tarifaire une stratégie commerciale devraient relire cette phrase deux fois.
• Disponibilité en retard, qui fait recommander par l’IA des produits que vous ne pouvez plus livrer.
Ce n’est pas qu’une impression de terrain. Selon le rapport trafic IA d’Adobe pour le deuxième trimestre, les fiches produits plafonnent à 63,5 en lisibilité pour citation IA, loin derrière les pages d’accueil et les guides d’achat qui tournent autour de 80. Les pages qui contiennent la donnée produit sont précisément celles que les machines lisent le plus mal. Chaque champ manquant agit comme un filtre silencieux : votre produit est approuvé, indexé, et invisible.
Le chantier, dans l’ordre
1. Éligibilité et dette technique. Diagnostics Merchant Center, refus, GTIN, écarts de prix. Et sortez tout de suite la liste des images sous 500 × 500 : c’est le seul point de cette liste avec une date butoir.
2. Spécificité. Vos 50 produits les plus gros en chiffre d’affaires : relisez titres et descriptions en vous demandant ce qu’une machine peut en extraire. Si la description reformule le titre, elle ne sert à rien.
3. Champs IA, par ordre de rendement. question_and_answer et document_link sur les meilleures ventes, puis variant_option si votre catalogue a des dimensions hors standard, puis related_product, puis popularity_rank. Sur les SKU qui font déjà du chiffre, pas sur les 40 000.
4. Fraîcheur et cadence. Prix et stock synchronisés en continu. Et une revue de flux au calendrier, mensuelle, avec un nom en face.
Lien interne possible vers un article sur l’optimisation des titres Google Shopping, et vers un article sur l’audit de flux Merchant Center.
Le flux, dernier endroit où vous tenez encore le signal
Depuis quatre ans, on demande aux annonceurs de lâcher les commandes une par une : enchères automatiques, PMax, ciblage élargi, génération d’assets. À chaque fois, la même question — qui contrôle le signal, et à quel point ?
Le shopping IA, ironiquement, vous en rend un. Le flux produit est resté déterministe. Vous écrivez le titre, vous déclarez la variante, vous rédigez la réponse à la question que l’acheteur va poser, vous choisissez quelle notice la machine a le droit de lire. Aucun modèle ne devine à votre place, aucun algorithme ne « réoptimise » votre GTIN pendant la nuit. C’est le dernier maillon de la chaîne où votre décision arrive intacte jusqu’à la machine.
Mais un signal, ça s’entretient. Kevin Indig résume la bascule mieux que n’importe quel livre blanc : la décennie précédente récompensait l’arbitrage marketing, le commerce agentique récompense « product truth ». Ce qui est vrai de votre produit, écrit proprement, dans un champ, et remis à jour quand ça change.
La prochaine fois que ChatGPT affiche huit produits à un acheteur, la seule question qui compte est de savoir si l’un d’eux est le vôtre. La réponse est dans un fichier — et dans la date à laquelle vous l’avez actualisé pour la dernière fois.
Article d’origine : AI shopping starts with your product feed, not your product page, Wasim Kagzi, Search Engine Land, 31 juillet 2026.